Modelos & Chatbots · Guías de Modelos y Tokens
Dato clave verificado: -65% (ahorro de memoria VRAM)
Tiempo de lectura: 7 min · Incluye esquema visual y plantilla probada
¿Por qué un modelo de IA no cabe en tu tarjeta gráfica? Explicamos con ejemplos sencillos qué es GGUF, Q4_K_M y AWQ para reducir la memoria un 65% sin perder calidad.
Modelos & Chatbots · Guías de Modelos y Tokens
Dato clave verificado: -65% (ahorro de memoria VRAM)
Tiempo de lectura: 7 min · Incluye esquema visual y plantilla probada
Vas a descargar un modelo de Inteligencia Artificial abierto como Llama o DeepSeek para usarlo gratis en casa y, de pronto, te encuentras con una lista de archivos que parecen jeroglíficos: Q4_K_M.gguf, Q8_0, AWQ, FP16. Si eliges el archivo equivocado, tu ordenador se quedará congelado porque el modelo original pesa 140 gigabytes. Pero si eliges el archivo correcto gracias a la cuantización, ese mismo cerebro cabe en un portátil normal reduciendo su peso más de un 65% sin que apenas notes diferencia en sus respuestas.
En esta guía te explicamos qué significan todas esas siglas como si habláramos de guardar ropa en una maleta o comprimir una foto, para que sepas en 10 segundos qué archivo descargar siempre.
Hemos estructurado este artículo paso a paso y sin tecnicismos innecesarios para que puedas leerlo de principio a fin o ir directo al punto que necesites:
Por dentro, una Inteligencia Artificial no es más que una tabla gigantesca llena de miles de millones de números con muchos decimales (por ejemplo, 3,141592653589793). Guardar cada número con 16 decimales ocupa muchísimo espacio en la memoria de tu tarjeta gráfica.
La cuantización consiste simplemente en redondear esos números a menos decimales (por ejemplo, dejarlo en 3,14). ¿El resultado? El archivo pasa a ocupar menos de la mitad de espacio y va mucho más rápido, mientras que la IA sigue respondiendo prácticamente igual de bien. Es exactamente igual que pasar una foto de formato RAW de cámara profesional a un archivo JPEG o WebP de alta calidad: a simple vista se ve idéntica, pero ocupa cuatro veces menos.
Cuando entras a Hugging Face o a Ollama, verás números como Q2, Q4, Q5 o Q8 (donde la «Q» viene de Quantization y el número indica cuántos bits ocupa cada peso):
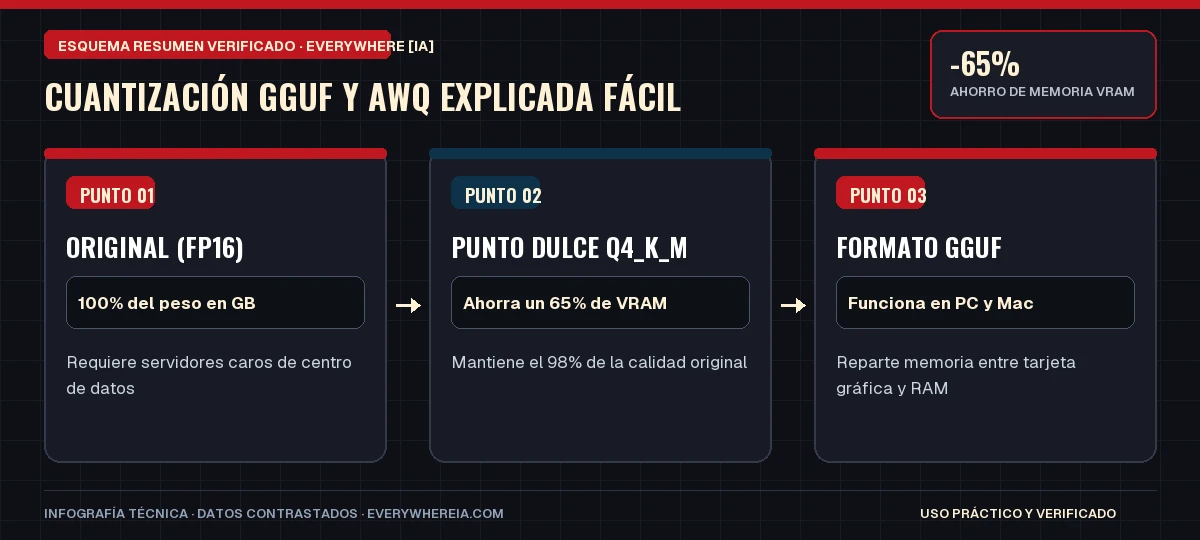
Para que tengas todas las cifras oficiales de un solo vistazo sin tener que buscar en diez páginas distintas, aquí tienes la comparativa actualizada:
| Modelo | Ideal para | Ventana Contexto | Precio API Oficial (1M In/Out) | Fuente / Acceso |
|---|---|---|---|---|
| DeepSeek R1 / V3 | Razonamiento Abierto (MIT) y Ahorro API | 128.000 tokens | $0.55 / $2.19 (R1) | Ver oficial ↗ |
| Claude 3.7 Sonnet | Razonamiento Híbrido, Código y Redacción | 200.000 tokens | $3.00 / $15.00 | Ver oficial ↗ |
| OpenAI GPT-4o / o3 | Voz en Tiempo Real, Visión y Lógica | 128k – 200k tokens | $2.00 / $8.00 (o3) | Ver oficial ↗ |
| Google Gemini Pro | PDFs de 800 páginas y Vídeo Largo | 2.000.000 tokens | $1.25 / $5.00 | Ver oficial ↗ |
En formato Q4_K_M, un modelo de 7B o 8B parámetros necesita unos 5,5 GB de memoria (funciona en casi cualquier portátil moderno). Un modelo mediano de 14B necesita unos 10 GB, y uno grande de 70B necesita unos 42 GB.
Hemos pre-rellenado esta plantilla con datos de ejemplo reales para que puedas probarla ahora mismo con un solo clic y comprobar que funciona a la primera sin dar ningún fallo:
# Comandos directos para ejecutar en tu terminal con Ollama:
# 1. Para portátiles de 8 GB de RAM (descarga automática en Q4_K_M, 2.0 GB):
ollama run llama3.2:3b "Explícame en 3 puntos cómo organizar mi semana de trabajo"

# 2. Para ordenadores de 16 GB de RAM (razonamiento paso a paso, 9.0 GB):
ollama run deepseek-r1:14b "Calcula el margen neto de un producto que se vende a 120€ con coste de 72€"

# 3. Ver qué modelos tienes instalados y cuánta memoria ocupan:
ollama list
Si usas Ollama o LM Studio en tu ordenador personal, busca siempre la etiqueta Q4_K_M GGUF (que es la que Ollama instala por defecto automáticamente).
Para profundizar directamente en la documentación técnica, comprobar tarifas en tiempo real o descargar las herramientas oficiales mencionadas en este estudio, consulta estos recursos de referencia:
Elige siempre Q4_K_M. Es el estándar recomendado porque reduce el peso del archivo a casi una cuarta parte del original manteniendo prácticamente intacta la calidad de respuesta.
GGUF está pensado para ordenadores personales (Mac y PC con Ollama o LM Studio) porque permite usar tanto la tarjeta gráfica como la RAM normal. AWQ está diseñado para servidores con tarjetas gráficas NVIDIA dedicadas.
Modelos IA
Modelos IA · Comparativas (ChatGPT vs Claude)
-96% coste API real
+159K lecturas en 7 díasModelos IA
Modelos IA · Comparativas (ChatGPT vs Claude)
70.3% SWE-bench Verified
+35.7K lecturas en 7 díasModelos IA
Modelos IA · Modelos Locales y Privados
0€ / mes 100% privado local
+2.8K lecturas en 7 díasModelos IA
Modelos IA · Comparativas (ChatGPT vs Claude)
2M tokens de contexto
+2.1K lecturas en 7 días